Đây là chuyện thật trong hệ thống của tôi. Gà Võ (shop thức ăn bổ sung cho gà), TradingPrimer và vài dự án khác đang chạy bằng một đội tác vụ AI theo lịch. Mỗi tác vụ có một bản hướng dẫn riêng, giống bản mô tả công việc của một nhân viên: làm gì, đọc file nào, xong thì trông thế nào, ghi nhật ký ra sao. Ngày 14/11, tôi giao cho tác vụ chưng cất kiến thức một việc chỉ đọc: chấm 100 bản hướng dẫn đó theo 10 mục, rồi xếp xem bản nào cần sửa trước. Kết quả làm tôi đổi hẳn cách nghĩ về "cải tiến AI".
Vì sao phải chấm bản hướng dẫn cho AI?
Khi đội AI còn 5–10 tác vụ, tôi nhớ hết từng bản. Khi lên gần 100, mỗi bản được vá thêm một đoạn sau mỗi sự cố, và không ai đọc lại từ đầu. Bản hướng dẫn tệ không làm AI dừng. Nó làm AI chạy đều, báo "xong" đều, nhưng làm sai chỗ hoặc làm thừa.
Trang hướng dẫn viết Skill chính thức của Anthropic cũng nói vài điều tương tự: phần mô tả phải nói cả việc làm gì lẫn khi nào dùng; phần thân nên dưới 500 dòng; và phải thử với đúng những model định dùng, vì hiệu quả của bản hướng dẫn phụ thuộc model chạy nó. Tôi lấy các ý đó làm nền, cộng những gì đã trả giá trong hệ thống, gom thành 10 mục. Riêng trần độ dài tôi đặt chặt hơn: 300 dòng.
10 mục tôi chấm, và kết quả từng mục
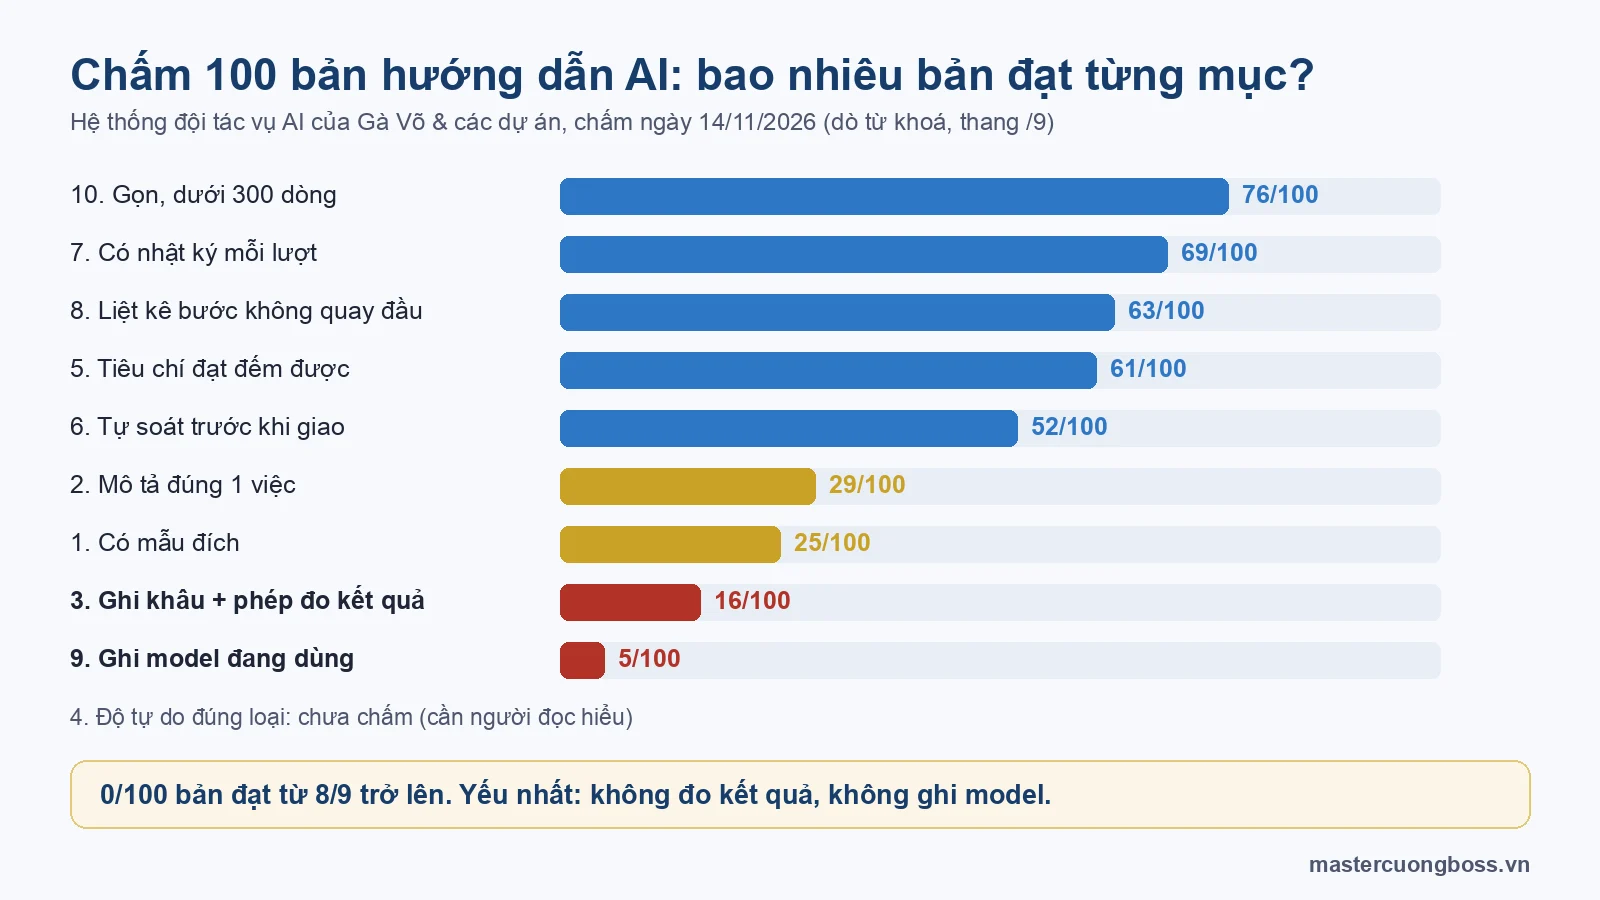
| Mục | Câu hỏi đạt/không đạt | Số bản có dấu hiệu đạt |
|---|---|---|
| 1. Mẫu đích | Có đầu ra mẫu đã duyệt, hoặc mô tả cụ thể "xong trông thế nào"? | 25/100 |
| 2. Một việc | Phần mô tả nêu đúng 1 việc + "dùng khi…", không gom nhiều loại đầu ra? | 29/100 |
| 3. Khâu + phép đo | Ghi rõ việc này đẩy khâu nào trong luồng tiền và đo bằng số nào? | 16/100 |
| 4. Độ tự do đúng loại | Phần quy tắc là bước đánh số; phần phán đoán chỉ ghi mục tiêu + tiêu chí? | Chưa chấm (cần người đọc) |
| 5. Tiêu chí đạt đếm được | Có điều kiện kiểu "= 0", "đủ N" và lối thoát trung thực khi không đạt? | 61/100 |
| 6. Tự soát | Có bước tự kiểm trước khi giao, việc công khai có lượt soát riêng? | 52/100 |
| 7. Nhật ký | Mỗi lượt ghi 1 dòng: kiểm gì, đếm ra mấy, vì sao dừng? | 69/100 |
| 8. Không quay đầu | Liệt kê bước không làm lại được; đích gửi/ghi khoá bằng mã cố định? | 63/100 |
| 9. Model | Ghi model/mức đang dùng và lần thử hạ gần nhất? | 5/100 |
| 10. Gọn | Dưới 300 dòng, luật chung chỉ trỏ tới file chung, không chép lại? | 76/100 |
Không bản nào đạt từ 8/9 trở lên. Nhưng tôi không thấy con số 0 đáng lo bằng hai dòng 3 và 9.
Hai lỗ hổng mà tôi không ngờ
Chỉ 16/100 bản ghi rõ khâu và phép đo. Đọc kỹ bản chăm sóc khách qua Zalo mới thấy vì sao. Bản đó có hẳn một mục "phép đo", nhưng toàn số hoạt động: bao nhiêu tin xếp hàng, bao nhiêu tin bị từ chối, bao nhiêu suất còn hụt. Không có dòng nào đo kết quả: khách có trả lời không, có đơn mua lại từ tin chăm sóc không. AI chạy đúng bản đó thì sẽ tối ưu cho việc gửi đủ tin, không phải cho việc khách quay lại.
Đây là nhận định tôi muốn nói thẳng: phần lớn bản hướng dẫn cho AI, của tôi và tôi đoán của nhiều người, đang đo sự bận rộn chứ không đo kết quả. Bận rộn thì AI làm rất giỏi.
Chỉ 5/100 bản ghi model đang dùng. Nghĩa là 95 bản còn lại tôi không biết đang chạy bằng model nào, đã thử hạ xuống model rẻ hơn bao giờ chưa. Muốn cắt chi phí AI mà không có dòng này thì chỉ đoán.
Sửa bản nào trước? Đừng sửa bản điểm thấp nhất
Phản xạ tự nhiên là xếp theo điểm và sửa từ dưới lên. Tôi suýt làm vậy. Rồi tôi ghép thêm cột "số lượt chạy trong 14 ngày" lấy từ Nhật ký đội AI, và bảng đảo ngược.
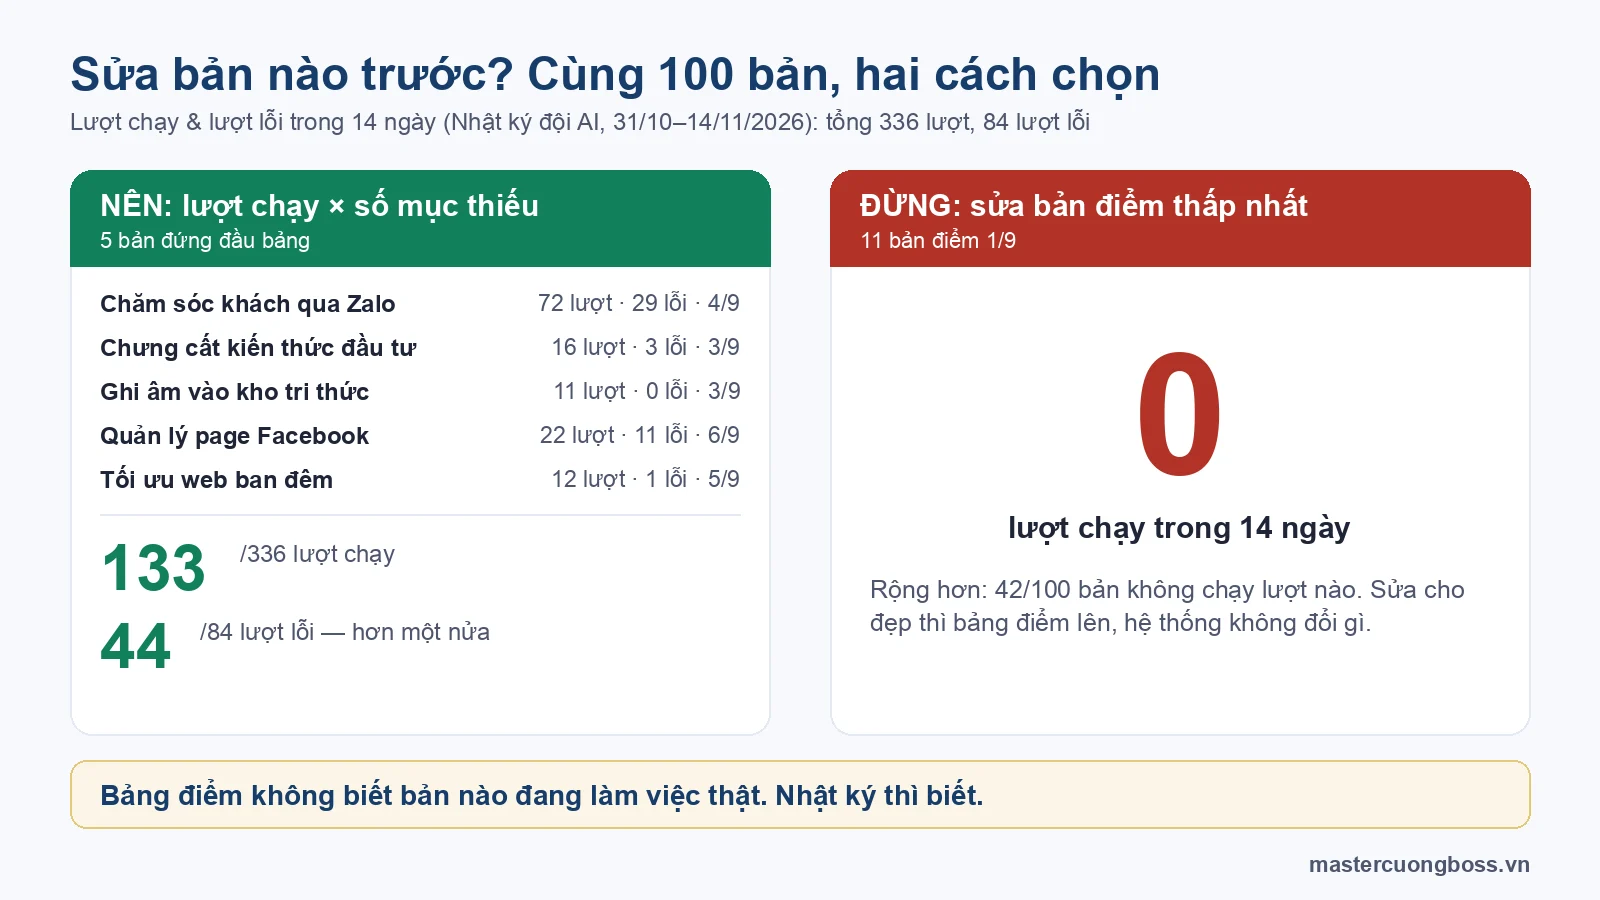
Trong 14 ngày, 100 bản này có 336 lượt chạy, 84 lượt ghi lỗi. Riêng bản chăm sóc khách Zalo chạy 72 lượt, tức khoảng 21% tổng lượt, và gánh 29 lượt lỗi, khoảng 35% tổng lỗi. Điểm của nó chỉ 4/9. Xếp theo "lượt × số mục thiếu", 5 bản đầu bảng chiếm 133 lượt chạy và 44 lượt lỗi, tức hơn một nửa số lượt lỗi.
Còn 11 bản điểm thấp nhất, 1/9? Tổng cộng 0 lượt chạy. Rộng hơn, 42/100 bản không chạy lượt nào trong 14 ngày. Sửa chúng cho đẹp thì bảng điểm lên, còn hệ thống không đổi gì.
Điều này nghe hiển nhiên khi viết ra, nhưng khi nhìn một bảng điểm đỏ rực, người ta luôn muốn xoá màu đỏ trước. Bảng điểm không biết bản nào đang làm việc thật. Nhật ký thì biết.
Chấm bằng máy để chọn, đọc bằng người để sửa
Từ chuyện trên, tôi chia việc thành hai bước rõ ràng:
- Máy chấm cả 100 bản bằng từ khoá, rẻ và nhanh, chỉ để trả lời một câu: đọc bản nào trước. Không dùng điểm này làm điểm cuối.
- Đọc hiểu đủ 10 mục cho 3 bản đầu bảng, ghi bằng chứng cho từng mục (thấy dòng nào, đoạn nào). Chỉ sửa sau khi đọc xong.
- Mỗi lượt sửa đúng 1 bản, có sao lưu. Sửa nhỏ (ghi chú đoạn nào hết hiệu lực) thì làm luôn; sửa lớn (đổi phần mô tả, đổi cách gửi) thì để tôi duyệt.
Bản Zalo đi đúng ba bước này: chấm 14/11, đọc kỹ 15/11, bước sửa nhỏ đầu tiên làm ngày 16/11. Phần sửa lớn hơn đang chờ tôi duyệt, nên tôi chưa có số trước/sau để kể. Có thì tôi sẽ viết tiếp.
Tự soi: bản hướng dẫn viết ra bài này được mấy điểm?
Bài bạn đang đọc do một tác vụ AI trong đội viết, theo bản hướng dẫn riêng. Bản đó cũng nằm trong bảng: 4/9, thiếu mục một việc, khâu + phép đo, tiêu chí đạt, tự soát, và model. Nó chạy ít lượt nên đứng giữa bảng, chưa đến lượt sửa.
Tôi để chuyện này vào bài vì nó đúng với tinh thần cả bài: chấm không phải để chứng minh mình làm tốt. Chấm là để biết sửa chỗ nào trước, kể cả khi chỗ đó là của chính mình.
Khối "10 câu chấm + thứ tự sửa" — chép về dùng
2. Phần mô tả nêu đúng 1 việc + "dùng khi…" không?
3. Có ghi việc này đẩy khâu nào (thu hút, tư vấn, chốt đơn, giao hàng, mua lại) và đo bằng số KẾT QUẢ nào không?
4. Phần quy tắc có thành bước đánh số, phần phán đoán chỉ ghi mục tiêu + tiêu chí không?
5. Có điều kiện đạt đếm được ("= 0", "đủ N") và cho phép báo "không đạt + lý do" không?
6. Có bước tự kiểm trước khi giao không?
7. Mỗi lượt có ghi 1 dòng nhật ký: kiểm gì, ra mấy, vì sao dừng không?
8. Có liệt kê bước không làm lại được, và nơi gửi/ghi khoá bằng mã cố định không?
9. Có ghi model đang dùng và lần thử hạ gần nhất không?
10. Dưới 300 dòng, luật chung chỉ trỏ tới file chung không?
Thứ tự sửa: điểm ưu tiên = số lượt chạy 14 ngày × số câu "không đạt". Đọc kỹ 3 bản cao nhất rồi mới sửa, mỗi lượt 1 bản.
Bắt đầu thế nào nếu bạn là doanh nghiệp nhỏ?
- Gom mọi bản hướng dẫn AI về một chỗ: prompt dán trong ChatGPT, Project của Claude, kịch bản chatbot. Chưa gom được thì chưa chấm được.
- Ghi số lần dùng mỗi bản trong 2 tuần, đếm tay cũng được. Đây là cột quan trọng nhất, quan trọng hơn cả điểm.
- Chấm nhanh 10 câu ở trên, mỗi bản 5 phút. Có thể nhờ AI chấm hộ, nhưng coi đó là bảng chọn, không phải kết luận.
- Sửa câu 3 trước cho bản dùng nhiều nhất: viết một dòng "việc này đo bằng số nào". Ví dụ chatbot trả lời khách: đo số khách để lại số điện thoại, không đo số tin đã trả lời.
- Bản không ai dùng trong 2 tuần thì cất đi, đừng tốn công sửa.
Khoá học 2 ngày của tôi dựng trọn hệ thống — bộ não, đội agent, tác vụ tự chạy mỗi sáng, cổng kiểm trước khi báo xong — trên chính máy của bạn. Hoặc gói Đồng hành, tôi vào tận doanh nghiệp set up cùng bạn.
Xem khoá học & gói Đồng hành →